| 1 |
# 内部架构 |
| 2 |
|
| 3 |
本部分记录了一些设计和实现细节。 |
| 4 |
|
| 5 |
[TOC] |
| 6 |
|
| 7 |
# 架构 {#Architecture} |
| 8 |
|
| 9 |
## SAX 和 DOM |
| 10 |
|
| 11 |
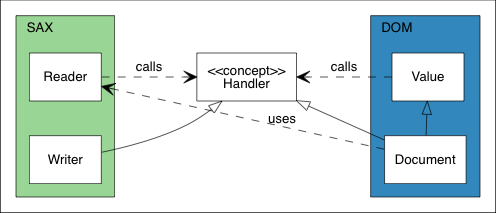
下面的 UML 图显示了 SAX 和 DOM 的基本关系。 |
| 12 |
|
| 13 |
 |
| 14 |
|
| 15 |
关系的核心是 `Handler` 概念。在 SAX 一边,`Reader` 从流解析 JSON 并将事件发送到 `Handler`。`Writer` 实现了 `Handler` 概念,用于处理相同的事件。在 DOM 一边,`Document` 实现了 `Handler` 概念,用于通过这些时间来构建 DOM。`Value` 支持了 `Value::Accept(Handler&)` 函数,它可以将 DOM 转换为事件进行发送。 |
| 16 |
|
| 17 |
在这个设计,SAX 是不依赖于 DOM 的。甚至 `Reader` 和 `Writer` 之间也没有依赖。这提供了连接事件发送器和处理器的灵活性。除此之外,`Value` 也是不依赖于 SAX 的。所以,除了将 DOM 序列化为 JSON 之外,用户也可以将其序列化为 XML,或者做任何其他事情。 |
| 18 |
|
| 19 |
## 工具类 |
| 20 |
|
| 21 |
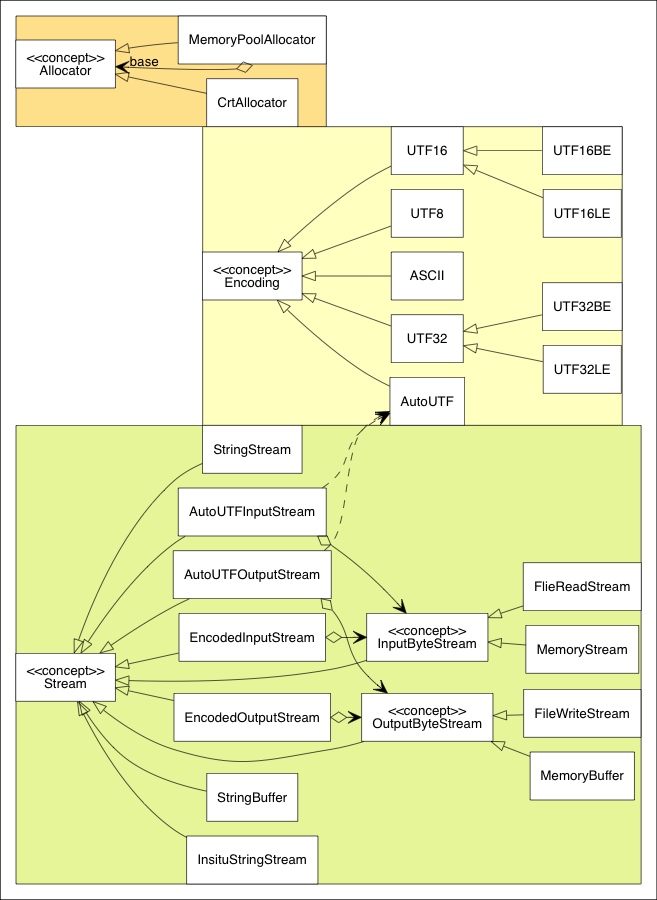
SAX 和 DOM API 都依赖于3个额外的概念:`Allocator`、`Encoding` 和 `Stream`。它们的继承层次结构如下图所示。 |
| 22 |
|
| 23 |
 |
| 24 |
|
| 25 |
# 值(Value) {#Value} |
| 26 |
|
| 27 |
`Value` (实际上被定义为 `GenericValue<UTF8<>>`)是 DOM API 的核心。本部分描述了它的设计。 |
| 28 |
|
| 29 |
## 数据布局 {#DataLayout} |
| 30 |
|
| 31 |
`Value` 是[可变类型](http://en.wikipedia.org/wiki/Variant_type)。在 RapidJSON 的上下文中,一个 `Value` 的实例可以包含6种 JSON 数据类型之一。通过使用 `union` ,这是可能实现的。每一个 `Value` 包含两个成员:`union Data data_` 和 `unsigned flags_`。`flags_` 表明了 JSON 类型,以及附加的信息。 |
| 32 |
|
| 33 |
下表显示了所有类型的数据布局。32位/64位列表明了字段所占用的字节数。 |
| 34 |
|
| 35 |
| Null | | 32位 | 64位 | |
| 36 |
|-------------------|----------------------------------|:----:|:----:| |
| 37 |
| (未使用) | |4 |8 | |
| 38 |
| (未使用) | |4 |4 | |
| 39 |
| (未使用) | |4 |4 | |
| 40 |
| `unsigned flags_` | `kNullType kNullFlag` |4 |4 | |
| 41 |
|
| 42 |
| Bool | | 32位 | 64位 | |
| 43 |
|-------------------|----------------------------------------------------|:----:|:----:| |
| 44 |
| (未使用) | |4 |8 | |
| 45 |
| (未使用) | |4 |4 | |
| 46 |
| (未使用) | |4 |4 | |
| 47 |
| `unsigned flags_` | `kBoolType` (either `kTrueFlag` or `kFalseFlag`) |4 |4 | |
| 48 |
|
| 49 |
| String | | 32位 | 64位 | |
| 50 |
|---------------------|-------------------------------------|:----:|:----:| |
| 51 |
| `Ch* str` | 指向字符串的指针(可能拥有所有权) |4 |8 | |
| 52 |
| `SizeType length` | 字符串长度 |4 |4 | |
| 53 |
| (未使用) | |4 |4 | |
| 54 |
| `unsigned flags_` | `kStringType kStringFlag ...` |4 |4 | |
| 55 |
|
| 56 |
| Object | | 32位 | 64位 | |
| 57 |
|---------------------|-------------------------------------|:----:|:----:| |
| 58 |
| `Member* members` | 指向成员数组的指针(拥有所有权) |4 |8 | |
| 59 |
| `SizeType size` | 成员数量 |4 |4 | |
| 60 |
| `SizeType capacity` | 成员容量 |4 |4 | |
| 61 |
| `unsigned flags_` | `kObjectType kObjectFlag` |4 |4 | |
| 62 |
|
| 63 |
| Array | | 32位 | 64位 | |
| 64 |
|---------------------|-------------------------------------|:----:|:----:| |
| 65 |
| `Value* values` | 指向值数组的指针(拥有所有权) |4 |8 | |
| 66 |
| `SizeType size` | 值数量 |4 |4 | |
| 67 |
| `SizeType capacity` | 值容量 |4 |4 | |
| 68 |
| `unsigned flags_` | `kArrayType kArrayFlag` |4 |4 | |
| 69 |
|
| 70 |
| Number (Int) | | 32位 | 64位 | |
| 71 |
|---------------------|-------------------------------------|:----:|:----:| |
| 72 |
| `int i` | 32位有符号整数 |4 |4 | |
| 73 |
| (零填充) | 0 |4 |4 | |
| 74 |
| (未使用) | |4 |8 | |
| 75 |
| `unsigned flags_` | `kNumberType kNumberFlag kIntFlag kInt64Flag ...` |4 |4 | |
| 76 |
|
| 77 |
| Number (UInt) | | 32位 | 64位 | |
| 78 |
|---------------------|-------------------------------------|:----:|:----:| |
| 79 |
| `unsigned u` | 32位无符号整数 |4 |4 | |
| 80 |
| (零填充) | 0 |4 |4 | |
| 81 |
| (未使用) | |4 |8 | |
| 82 |
| `unsigned flags_` | `kNumberType kNumberFlag kUintFlag kUint64Flag ...` |4 |4 | |
| 83 |
|
| 84 |
| Number (Int64) | | 32位 | 64位 | |
| 85 |
|---------------------|-------------------------------------|:----:|:----:| |
| 86 |
| `int64_t i64` | 64位有符号整数 |8 |8 | |
| 87 |
| (未使用) | |4 |8 | |
| 88 |
| `unsigned flags_` | `kNumberType kNumberFlag kInt64Flag ...` |4 |4 | |
| 89 |
|
| 90 |
| Number (Uint64) | | 32位 | 64位 | |
| 91 |
|---------------------|-------------------------------------|:----:|:----:| |
| 92 |
| `uint64_t i64` | 64位无符号整数 |8 |8 | |
| 93 |
| (未使用) | |4 |8 | |
| 94 |
| `unsigned flags_` | `kNumberType kNumberFlag kInt64Flag ...` |4 |4 | |
| 95 |
|
| 96 |
| Number (Double) | | 32位 | 64位 | |
| 97 |
|---------------------|-------------------------------------|:----:|:----:| |
| 98 |
| `uint64_t i64` | 双精度浮点数 |8 |8 | |
| 99 |
| (未使用) | |4 |8 | |
| 100 |
| `unsigned flags_` |`kNumberType kNumberFlag kDoubleFlag`|4 |4 | |
| 101 |
|
| 102 |
这里有一些需要注意的地方: |
| 103 |
* 为了减少在64位架构上的内存消耗,`SizeType` 被定义为 `unsigned` 而不是 `size_t`。 |
| 104 |
* 32位整数的零填充可能被放在实际类型的前面或后面,这依赖于字节序。这使得它可以将32位整数不经过任何转换就可以解释为64位整数。 |
| 105 |
* `Int` 永远是 `Int64`,反之不然。 |
| 106 |
|
| 107 |
## 标志 {#Flags} |
| 108 |
|
| 109 |
32位的 `flags_` 包含了 JSON 类型和其他信息。如前文中的表所述,每一种 JSON 类型包含了冗余的 `kXXXType` 和 `kXXXFlag`。这个设计是为了优化测试位标志(`IsNumber()`)和获取每一种类型的序列号(`GetType()`)。 |
| 110 |
|
| 111 |
字符串有两个可选的标志。`kCopyFlag` 表明这个字符串拥有字符串拷贝的所有权。而 `kInlineStrFlag` 意味着使用了[短字符串优化](#ShortString)。 |
| 112 |
|
| 113 |
数字更加复杂一些。对于普通的整数值,它可以包含 `kIntFlag`、`kUintFlag`、 `kInt64Flag` 和/或 `kUint64Flag`,这由整数的范围决定。带有小数或者超过64位所能表达的范围的整数的数字会被存储为带有 `kDoubleFlag` 的 `double`。 |
| 114 |
|
| 115 |
## 短字符串优化 {#ShortString} |
| 116 |
|
| 117 |
[Kosta](https://github.com/Kosta-Github) 提供了很棒的短字符串优化。这个优化的xxx如下所述。除去 `flags_` ,`Value` 有12或16字节(对于32位或64位)来存储实际的数据。这为在其内部直接存储短字符串而不是存储字符串的指针创造了可能。对于1字节的字符类型(例如 `char`),它可以在 `Value` 类型内部存储至多11或15个字符的字符串。 |
| 118 |
|
| 119 |
|ShortString (Ch=char)| | 32位 | 64位 | |
| 120 |
|---------------------|-------------------------------------|:----:|:----:| |
| 121 |
| `Ch str[MaxChars]` | 字符串缓冲区 |11 |15 | |
| 122 |
| `Ch invLength` | MaxChars - Length |1 |1 | |
| 123 |
| `unsigned flags_` | `kStringType kStringFlag ...` |4 |4 | |
| 124 |
|
| 125 |
这里使用了一项特殊的技术。它存储了 (MaxChars - length) 而不直接存储字符串的长度。这使得存储11个字符并且带有后缀 `\0` 成为可能。 |
| 126 |
|
| 127 |
这个优化可以减少字符串拷贝内存占用。它也改善了缓存一致性,并进一步提高了运行时性能。 |
| 128 |
|
| 129 |
# 分配器(Allocator) {#InternalAllocator} |
| 130 |
|
| 131 |
`Allocator` 是 RapidJSON 中的概念: |
| 132 |
~~~cpp |
| 133 |
concept Allocator { |
| 134 |
static const bool kNeedFree; //!< 表明这个分配器是否需要调用 Free()。 |
| 135 |
|
| 136 |
// 申请内存块。 |
| 137 |
// \param size 内存块的大小,以字节记。 |
| 138 |
// \returns 指向内存块的指针。 |
| 139 |
void* Malloc(size_t size); |
| 140 |
|
| 141 |
// 调整内存块的大小。 |
| 142 |
// \param originalPtr 当前内存块的指针。空指针是被允许的。 |
| 143 |
// \param originalSize 当前大小,以字节记。(设计问题:因为有些分配器可能不会记录它,显示的传递它可以节约内存。) |
| 144 |
// \param newSize 新大小,以字节记。 |
| 145 |
void* Realloc(void* originalPtr, size_t originalSize, size_t newSize); |
| 146 |
|
| 147 |
// 释放内存块。 |
| 148 |
// \param ptr 指向内存块的指针。空指针是被允许的。 |
| 149 |
static void Free(void *ptr); |
| 150 |
}; |
| 151 |
~~~ |
| 152 |
|
| 153 |
需要注意的是 `Malloc()` 和 `Realloc()` 是成员函数而 `Free()` 是静态成员函数。 |
| 154 |
|
| 155 |
## MemoryPoolAllocator {#MemoryPoolAllocator} |
| 156 |
|
| 157 |
`MemoryPoolAllocator` 是 DOM 的默认内存分配器。它只申请内存而不释放内存。这对于构建 DOM 树非常合适。 |
| 158 |
|
| 159 |
在它的内部,它从基础的内存分配器申请内存块(默认为 `CrtAllocator`)并将这些内存块存储为单向链表。当用户请求申请内存,它会遵循下列步骤来申请内存: |
| 160 |
|
| 161 |
1. 如果可用,使用用户提供的缓冲区。(见 [User Buffer section in DOM](doc/dom.md)) |
| 162 |
2. 如果用户提供的缓冲区已满,使用当前内存块。 |
| 163 |
3. 如果当前内存块已满,申请新的内存块。 |
| 164 |
|
| 165 |
# 解析优化 {#ParsingOptimization} |
| 166 |
|
| 167 |
## 使用 SIMD 跳过空格 {#SkipwhitespaceWithSIMD} |
| 168 |
|
| 169 |
当从流中解析 JSON 时,解析器需要跳过4种空格字符: |
| 170 |
|
| 171 |
1. 空格 (`U+0020`) |
| 172 |
2. 制表符 (`U+000B`) |
| 173 |
3. 换行 (`U+000A`) |
| 174 |
4. 回车 (`U+000D`) |
| 175 |
|
| 176 |
这是一份简单的实现: |
| 177 |
~~~cpp |
| 178 |
void SkipWhitespace(InputStream& s) { |
| 179 |
while (s.Peek() == ' ' || s.Peek() == '\n' || s.Peek() == '\r' || s.Peek() == '\t') |
| 180 |
s.Take(); |
| 181 |
} |
| 182 |
~~~ |
| 183 |
|
| 184 |
但是,这需要对每个字符进行4次比较以及一些分支。这被发现是一个热点。 |
| 185 |
|
| 186 |
为了加速这一处理,RapidJSON 使用 SIMD 来在一次迭代中比较16个字符和4个空格。目前 RapidJSON 支持 SSE2 , SSE4.2 和 ARM Neon 指令。同时它也只会对 UTF-8 内存流启用,包括字符串流或 *原位* 解析。 |
| 187 |
|
| 188 |
你可以通过在包含 `rapidjson.h` 之前定义 `RAPIDJSON_SSE2` , `RAPIDJSON_SSE42` 或 `RAPIDJSON_NEON` 来启用这个优化。一些编译器可以检测这个设置,如 `perftest.h`: |
| 189 |
|
| 190 |
~~~cpp |
| 191 |
// __SSE2__ 和 __SSE4_2__ 可被 gcc、clang 和 Intel 编译器识别: |
| 192 |
// 如果支持的话,我们在 gmake 中使用了 -march=native 来启用 -msse2 和 -msse4.2 |
| 193 |
// 同样的, __ARM_NEON 被用于识别Neon |
| 194 |
#if defined(__SSE4_2__) |
| 195 |
# define RAPIDJSON_SSE42 |
| 196 |
#elif defined(__SSE2__) |
| 197 |
# define RAPIDJSON_SSE2 |
| 198 |
#elif defined(__ARM_NEON) |
| 199 |
# define RAPIDJSON_NEON |
| 200 |
#endif |
| 201 |
~~~ |
| 202 |
|
| 203 |
需要注意的是,这是编译期的设置。在不支持这些指令的机器上运行可执行文件会使它崩溃。 |
| 204 |
|
| 205 |
### 页面对齐问题 |
| 206 |
|
| 207 |
在 RapidJSON 的早期版本中,被报告了[一个问题](https://code.google.com/archive/p/rapidjson/issues/104):`SkipWhitespace_SIMD()` 会罕见地导致崩溃(约五十万分之一的几率)。在调查之后,怀疑是 `_mm_loadu_si128()` 访问了 `'\0'` 之后的内存,并越过被保护的页面边界。 |
| 208 |
|
| 209 |
在 [Intel® 64 and IA-32 Architectures Optimization Reference Manual |
| 210 |
](http://www.intel.com/content/www/us/en/architecture-and-technology/64-ia-32-architectures-optimization-manual.html) 中,章节 10.2.1: |
| 211 |
|
| 212 |
> 为了支持需要费对齐的128位 SIMD 内存访问的算法,调用者的内存缓冲区申请应当考虑添加一些填充空间,这样被调用的函数可以安全地将地址指针用于未对齐的128位 SIMD 内存操作。 |
| 213 |
> 在结合非对齐的 SIMD 内存操作中,最小的对齐大小应该等于 SIMD 寄存器的大小。 |
| 214 |
|
| 215 |
对于 RapidJSON 来说,这显然是不可行的,因为 RapidJSON 不应当强迫用户进行内存对齐。 |
| 216 |
|
| 217 |
为了修复这个问题,当前的代码会先按字节处理直到下一个对齐的地址。在这之后,使用对齐读取来进行 SIMD 处理。见 [#85](https://github.com/Tencent/rapidjson/issues/85)。 |
| 218 |
|
| 219 |
## 局部流拷贝 {#LocalStreamCopy} |
| 220 |
|
| 221 |
在优化的过程中,我们发现一些编译器不能将访问流的一些成员数据放入局部变量或者寄存器中。测试结果显示,对于一些流类型,创建流的拷贝并将其用于内层循环中可以改善性能。例如,实际(非 SIMD)的 `SkipWhitespace()` 被实现为: |
| 222 |
|
| 223 |
~~~cpp |
| 224 |
template<typename InputStream> |
| 225 |
void SkipWhitespace(InputStream& is) { |
| 226 |
internal::StreamLocalCopy<InputStream> copy(is); |
| 227 |
InputStream& s(copy.s); |
| 228 |
|
| 229 |
while (s.Peek() == ' ' || s.Peek() == '\n' || s.Peek() == '\r' || s.Peek() == '\t') |
| 230 |
s.Take(); |
| 231 |
} |
| 232 |
~~~ |
| 233 |
|
| 234 |
基于流的特征,`StreamLocalCopy` 会创建(或不创建)流对象的拷贝,在局部使用它并将流的状态拷贝回原来的流。 |
| 235 |
|
| 236 |
## 解析为双精度浮点数 {#ParsingDouble} |
| 237 |
|
| 238 |
将字符串解析为 `double` 并不简单。标准库函数 `strtod()` 可以胜任这项工作,但它比较缓慢。默认情况下,解析器使用默认的精度设置。这最多有 3[ULP](http://en.wikipedia.org/wiki/Unit_in_the_last_place) 的误差,并实现在 `internal::StrtodNormalPrecision()` 中。 |
| 239 |
|
| 240 |
当使用 `kParseFullPrecisionFlag` 时,编译器会改为调用 `internal::StrtodFullPrecision()` ,这个函数会自动调用三个版本的转换。 |
| 241 |
1. [Fast-Path](http://www.exploringbinary.com/fast-path-decimal-to-floating-point-conversion/)。 |
| 242 |
2. [double-conversion](https://github.com/floitsch/double-conversion) 中的自定义 DIY-FP 实现。 |
| 243 |
3. (Clinger, William D. How to read floating point numbers accurately. Vol. 25. No. 6. ACM, 1990) 中的大整数算法。 |
| 244 |
|
| 245 |
如果第一个转换方法失败,则尝试使用第二种方法,以此类推。 |
| 246 |
|
| 247 |
# 生成优化 {#GenerationOptimization} |
| 248 |
|
| 249 |
## 整数到字符串的转换 {#itoa} |
| 250 |
|
| 251 |
整数到字符串转换的朴素算法需要对每一个十进制位进行一次除法。我们实现了若干版本并在 [itoa-benchmark](https://github.com/miloyip/itoa-benchmark) 中对它们进行了评估。 |
| 252 |
|
| 253 |
虽然 SSE2 版本是最快的,但它和第二快的 `branchlut` 差距不大。而且 `branchlut` 是纯C++实现,所以我们在 RapidJSON 中使用了 `branchlut`。 |
| 254 |
|
| 255 |
## 双精度浮点数到字符串的转换 {#dtoa} |
| 256 |
|
| 257 |
原来 RapidJSON 使用 `snprintf(..., ..., "%g")` 来进行双精度浮点数到字符串的转换。这是不准确的,因为默认的精度是6。随后我们发现它很缓慢,而且有其它的替代品。 |
| 258 |
|
| 259 |
Google 的 V8 [double-conversion](https://github.com/floitsch/double-conversion |
| 260 |
) 实现了更新的、快速的被称为 Grisu3 的算法(Loitsch, Florian. "Printing floating-point numbers quickly and accurately with integers." ACM Sigplan Notices 45.6 (2010): 233-243.)。 |
| 261 |
|
| 262 |
然而,这个实现不是仅头文件的,所以我们实现了一个仅头文件的 Grisu2 版本。这个算法保证了结果永远精确。而且在大多数情况下,它会生成最短的(可选)字符串表示。 |
| 263 |
|
| 264 |
这个仅头文件的转换函数在 [dtoa-benchmark](https://github.com/miloyip/dtoa-benchmark) 中进行评估。 |
| 265 |
|
| 266 |
# 解析器 {#Parser} |
| 267 |
|
| 268 |
## 迭代解析 {#IterativeParser} |
| 269 |
|
| 270 |
迭代解析器是一个以非递归方式实现的递归下降的 LL(1) 解析器。 |
| 271 |
|
| 272 |
### 语法 {#IterativeParserGrammar} |
| 273 |
|
| 274 |
解析器使用的语法是基于严格 JSON 语法的: |
| 275 |
~~~~~~~~~~ |
| 276 |
S -> array | object |
| 277 |
array -> [ values ] |
| 278 |
object -> { members } |
| 279 |
values -> non-empty-values | ε |
| 280 |
non-empty-values -> value addition-values |
| 281 |
addition-values -> ε | , non-empty-values |
| 282 |
members -> non-empty-members | ε |
| 283 |
non-empty-members -> member addition-members |
| 284 |
addition-members -> ε | , non-empty-members |
| 285 |
member -> STRING : value |
| 286 |
value -> STRING | NUMBER | NULL | BOOLEAN | object | array |
| 287 |
~~~~~~~~~~ |
| 288 |
|
| 289 |
注意到左因子被加入了非终结符的 `values` 和 `members` 来保证语法是 LL(1) 的。 |
| 290 |
|
| 291 |
### 解析表 {#IterativeParserParsingTable} |
| 292 |
|
| 293 |
基于这份语法,我们可以构造 FIRST 和 FOLLOW 集合。 |
| 294 |
|
| 295 |
非终结符的 FIRST 集合如下所示: |
| 296 |
|
| 297 |
| NON-TERMINAL | FIRST | |
| 298 |
|:-----------------:|:--------------------------------:| |
| 299 |
| array | [ | |
| 300 |
| object | { | |
| 301 |
| values | ε STRING NUMBER NULL BOOLEAN { [ | |
| 302 |
| addition-values | ε COMMA | |
| 303 |
| members | ε STRING | |
| 304 |
| addition-members | ε COMMA | |
| 305 |
| member | STRING | |
| 306 |
| value | STRING NUMBER NULL BOOLEAN { [ | |
| 307 |
| S | [ { | |
| 308 |
| non-empty-members | STRING | |
| 309 |
| non-empty-values | STRING NUMBER NULL BOOLEAN { [ | |
| 310 |
|
| 311 |
FOLLOW 集合如下所示: |
| 312 |
|
| 313 |
| NON-TERMINAL | FOLLOW | |
| 314 |
|:-----------------:|:-------:| |
| 315 |
| S | $ | |
| 316 |
| array | , $ } ] | |
| 317 |
| object | , $ } ] | |
| 318 |
| values | ] | |
| 319 |
| non-empty-values | ] | |
| 320 |
| addition-values | ] | |
| 321 |
| members | } | |
| 322 |
| non-empty-members | } | |
| 323 |
| addition-members | } | |
| 324 |
| member | , } | |
| 325 |
| value | , } ] | |
| 326 |
|
| 327 |
最终可以从 FIRST 和 FOLLOW 集合生成解析表: |
| 328 |
|
| 329 |
| NON-TERMINAL | [ | { | , | : | ] | } | STRING | NUMBER | NULL | BOOLEAN | |
| 330 |
|:-----------------:|:---------------------:|:---------------------:|:-------------------:|:-:|:-:|:-:|:-----------------------:|:---------------------:|:---------------------:|:---------------------:| |
| 331 |
| S | array | object | | | | | | | | | |
| 332 |
| array | [ values ] | | | | | | | | | | |
| 333 |
| object | | { members } | | | | | | | | | |
| 334 |
| values | non-empty-values | non-empty-values | | | ε | | non-empty-values | non-empty-values | non-empty-values | non-empty-values | |
| 335 |
| non-empty-values | value addition-values | value addition-values | | | | | value addition-values | value addition-values | value addition-values | value addition-values | |
| 336 |
| addition-values | | | , non-empty-values | | ε | | | | | | |
| 337 |
| members | | | | | | ε | non-empty-members | | | | |
| 338 |
| non-empty-members | | | | | | | member addition-members | | | | |
| 339 |
| addition-members | | | , non-empty-members | | | ε | | | | | |
| 340 |
| member | | | | | | | STRING : value | | | | |
| 341 |
| value | array | object | | | | | STRING | NUMBER | NULL | BOOLEAN | |
| 342 |
|
| 343 |
对于上面的语法分析,这里有一个很棒的[工具](http://hackingoff.com/compilers/predict-first-follow-set)。 |
| 344 |
|
| 345 |
### 实现 {#IterativeParserImplementation} |
| 346 |
|
| 347 |
基于这份解析表,一个直接的(常规的)将规则反向入栈的实现可以正常工作。 |
| 348 |
|
| 349 |
在 RapidJSON 中,对直接的实现进行了一些修改: |
| 350 |
|
| 351 |
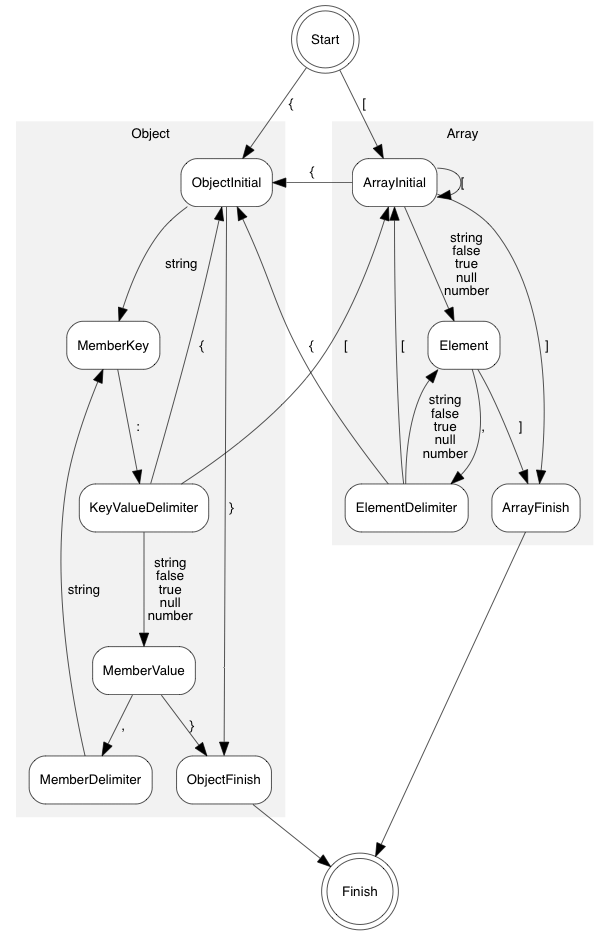
首先,在 RapidJSON 中,这份解析表被编码为状态机。 |
| 352 |
规则由头部和主体组成。 |
| 353 |
状态转换由规则构造。 |
| 354 |
除此之外,额外的状态被添加到与 `array` 和 `object` 有关的规则。 |
| 355 |
通过这种方式,生成数组值或对象成员可以只用一次状态转移便可完成, |
| 356 |
而不需要在直接的实现中的多次出栈/入栈操作。 |
| 357 |
这也使得估计栈的大小更加容易。 |
| 358 |
|
| 359 |
状态图如如下所示: |
| 360 |
|
| 361 |
 |
| 362 |
|
| 363 |
第二,迭代解析器也在内部栈保存了数组的值个数和对象成员的数量,这也与传统的实现不同。 |